この記事は、Amy Chang(Head of AI Threat Intelligence and Security Research, AI Software & Platform) 、Nicholas Conley(AI Defense Researcher, AI Software & Platform)、によるブログ記事「LLM Security Leaderboard Now Ranks Every Modality Where Agent Risk Lives: Text, Image, and Audio」(2026 年 9 月 24 日)の抄訳です。


本件の研究開発にあたっては Ravikumar Balakrishnan、Ankit Garg、Sanket Mendapara のサポートがありました
本年初頭に Cisco LLM Security Leaderboard の公開を開始した際に掲げていた目標はシンプルなものでした。それはモデルの攻撃に対する耐性を検証して得た明確なデータを提供することで、企業がモデルを導入する前にリスクを把握できるようにする、というものでした。これは重要な点です。AI モデルは、電子メールを読み、Web を閲覧し、利用者に代わってアクションを実行するエージェントなど、さまざまな製品に組み込まれるようになっているためです。操作されたモデルが、その利用者に対する攻撃に利用される可能性があります。そのリスクは導入環境によっても異なります。ブラウジングエージェントに接続されているモデルは、チャットウィンドウで質問に答えるだけのモデルよりも多岐にわたる入力(テキストや画像、音声などのモダリティ)にさらされています。そのため特定のモデルの弱みは、その強みと同じくらい重要な問題です。
このリーダーボードは数種類の方法でテストを行っています。たとえばモデルが処理するコンテンツ(Web ページや画像など)の中に悪意のある指示が隠されたプロンプトインジェクションや、モデルにそれ自体の安全に関わる規則を破るように指示するジェイルブレイクなどです。モデルに有害または安全でない出力を生成させるその他の手法も使用します。厳密な手法(単一のメッセージか長々とした会話か、そのままの内容か難読化されているか、あるいはテキスト、画像、音声かなど)は多様であり、検証の対象となる害の種類にも同様のことが言えますが、根っこの部分で共通しているのは「このモデルは操作できるのか?」という問題です。あるモデルは他のモデルよりも遥かに高い耐性があります。耐性の低いモデルをエージェントに接続すれば、リスクは増大します。
2026 年 6 月以降、全モダリティで新たな評価対象として 102 種を追加
LLM Security Leaderboard は、モデルのセキュリティを対象とした最も包括的なリーダーボードの 1 つです。シスコでは 6 月以降、新たに 102 のエントリを追加し、モデルの数は 3 つのモダリティで延べ 136 種類となりました。Anthropic、OpenAI、Google、xAI、Meta、Mistral などの最先端のリリース(フロンティアモデル)や、コアコンポーネントが一般公開されているもの(オープンウェイトモデル)など、多様なモデルが対象です。従来どおり、追加のガードレールを設けていない基本構成でモデルをテストしているため、スコアは追加のセキュリティ保護を適用する際の一貫したベースラインとなります。
マルチモーダルでの結果の公開を開始
リーダーボードではこれまで、テキストベースの攻撃を 2 つの方法で評価していました。1 つは有害なメッセージを直接モデルに送信するシングルターンという手法。もう 1 つはメッセージを複数回やり取りすることで時間をかけて要求の有害性を高めていくマルチターンという手法です。これは、人々がモデルとやり取りする最も一般的な方法を扱ったものです。しかし今日では、モデルは実際にアクションを実行できるエージェントの基盤にもなっています。
ツールを呼び出し、Web をブラウジングし、コンピューターを操作できるモデルがエージェントです。エージェントは自らが動作するあらゆる場所で情報を取り込みます。読み込むページ、開くファイル、表示する画像、ツールの実行結果など、すべてが対象です。攻撃者は、こうした入力経路のそれぞれに指示を仕込むことができます。また、指示が入力される形式はテキストだけではありません。エージェントがアクセスする Web サイトでは、広告などの画像にプロンプトインジェクションが埋め込まれている可能性があります。また、音声アシスタントには、それを操作するよう細工された音声クリップが渡される可能性があります。モデルがテキストで評価されるだけであれば、実際にインシデントが起きるまでそのリスクは表面化しないかもしれません。そうしたモデルのどの領域が、自社の導入環境というコンテキストにおいて実際に重大な意味を持つかを考えてみてください。テキストを読み書きするだけのエージェントであれば画像に対する耐性を心配する必要はありませんが、それが Web ブラウジングやスクリーンショットの読み取り、音声入力を受け付けるエージェントであれば話は違います。そうした環境は、テキストのみの評価ではセキュリティの全体像を語れません。
現在リーダーボードのアップデートをリリース中ですが、これは単純なテキストモデルを超えた拡張になります。新たに 69 のエントリを追加しており、Amazon、Anthropic、Google、Meta、Mistral、OpenAI、xAI 各社の 55 の画像モデルと 14 の音声モデルに対応しました。 これらの各ラボではマルチモーダル機能の構築とトレーニングに異なる手法を用いています。画像データを LLM のバックボーンにどのように取り込むか、ベースとなる言語モデルと比べてビジョンスタックや音声スタックにどの程度の安全性アライメントを組み込むか、あるいはどのモダリティを対象に社内でレッドチームテストや評価を実施するかなど、その手法はさまざまです。こうした違いは、あるモダリティと別のモダリティへの攻撃に対する、各モデルの耐性の比較において顕在化します。
画像攻撃と音声攻撃は、シングルターンのテキスト攻撃(1 つのメッセージで 1 度だけ試行)と同じ方法で検証されます。また、テキストスコアと同じ攻撃カテゴリおよび有害カテゴリを使用するため、対象領域全体で耐性を比較できます。各モデルの総合的な合計スコアは、そのモデルが評価されたすべての形式の平均値になりました。また、新しいモダリティ切り替え機能を使用すると、テキスト、画像、音声のスコアを個別に確認できます。これにより、AI の導入環境が実際にさらされている特定のモダリティに照らし合わせてモデルを検証し、そのモデルにおいて防御の強化が必要な箇所を判断できるようになります。入力に対するフィルタリングや出力に対する予防的な仕組みを導入するなど、そのモデルの弱点であるモダリティを補強できるということです。
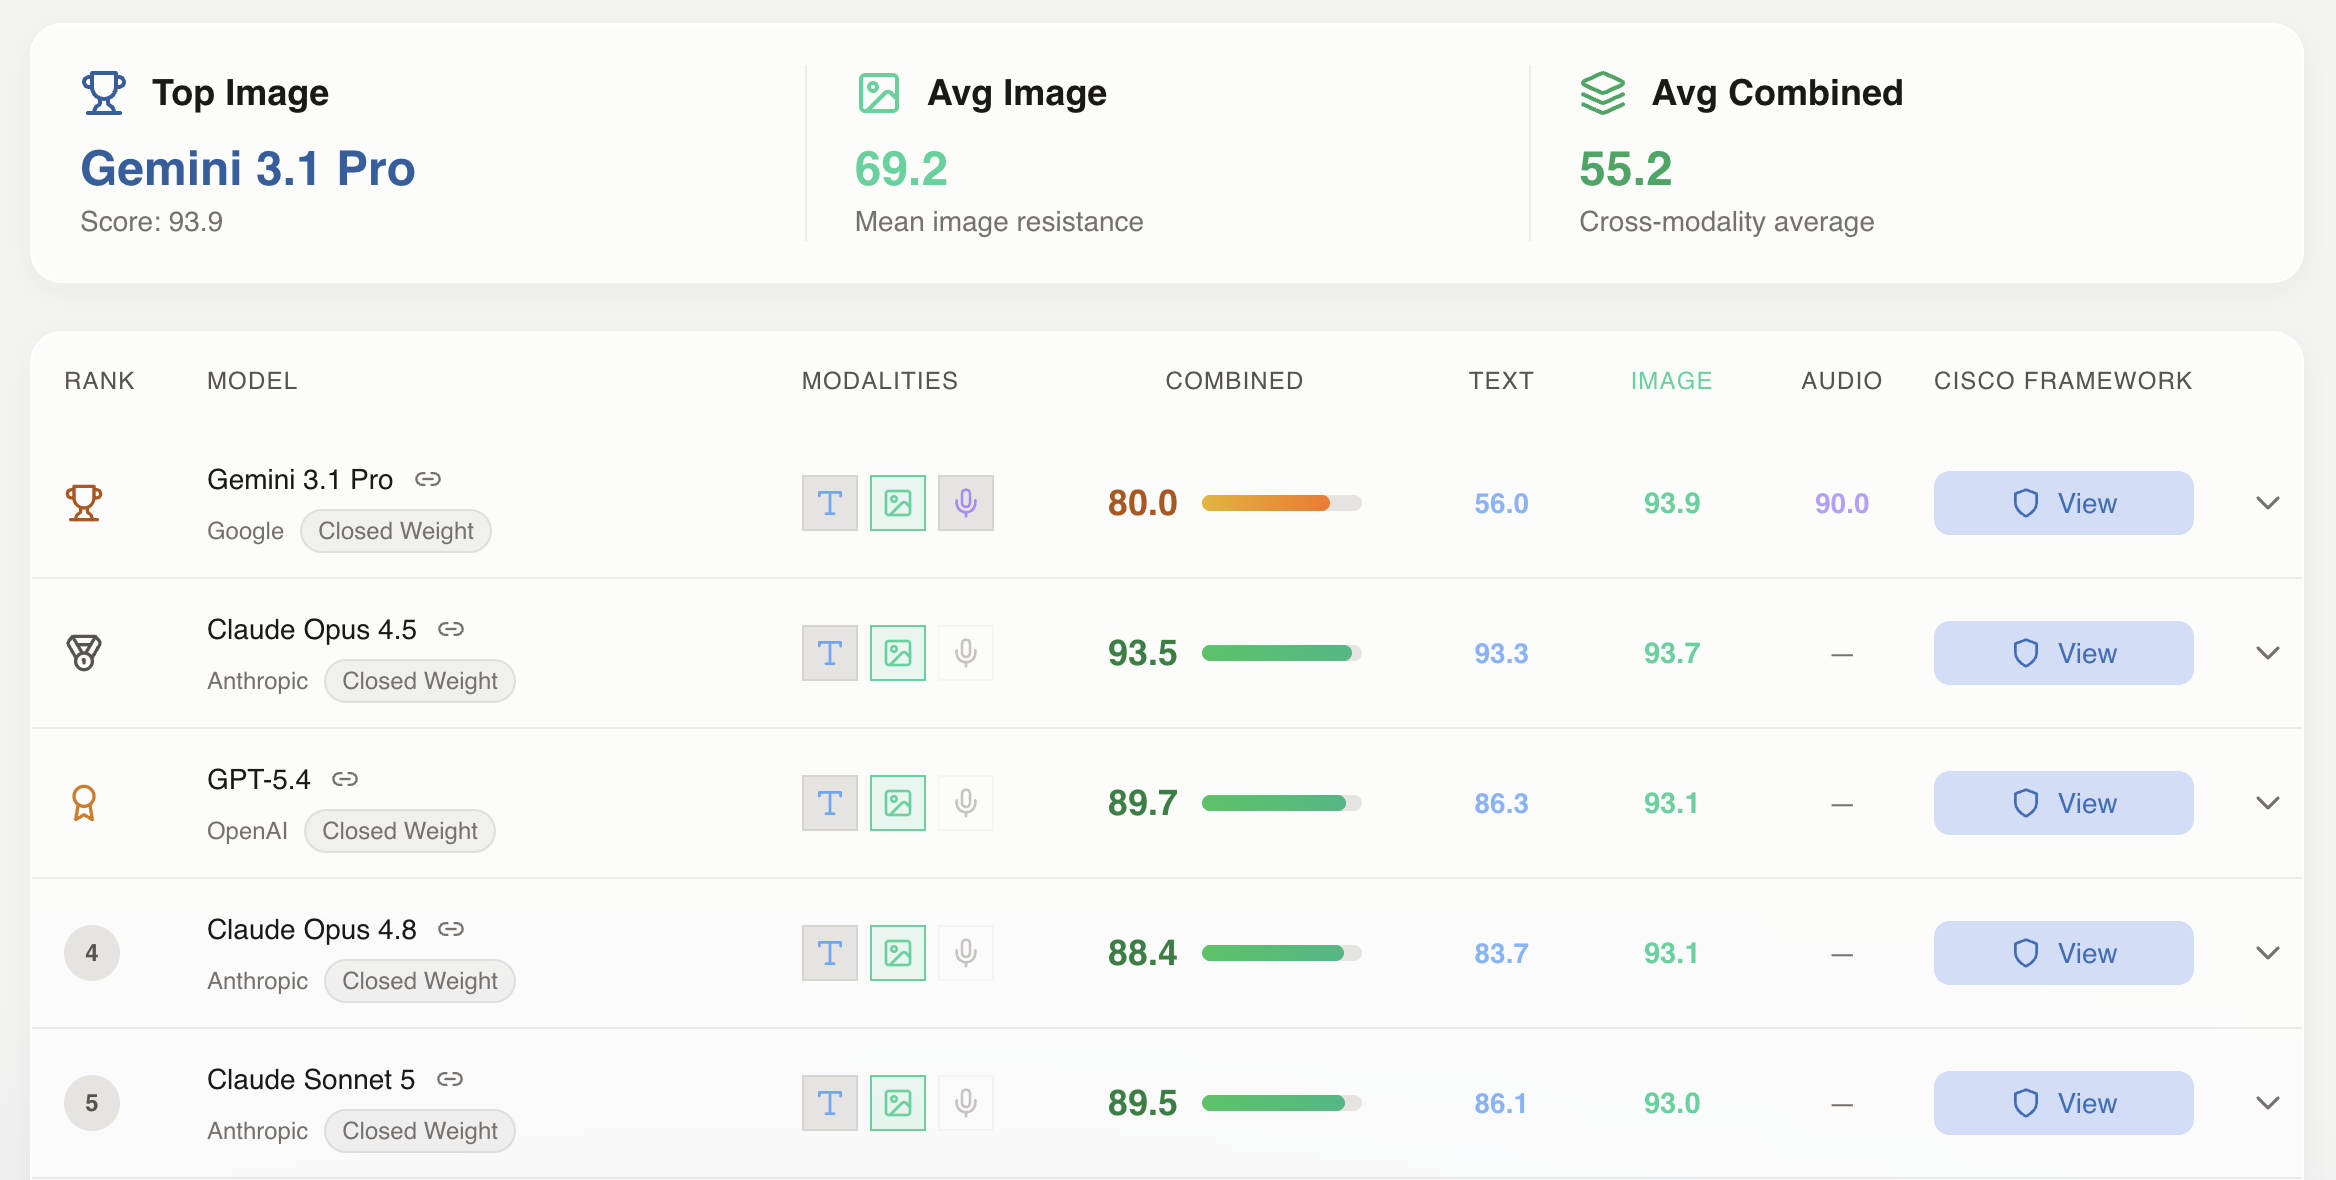
図 1. Cisco LLM Security Leaderboard の画像対応モデルランキングのスクリーンショット
画像モデルのリーダーボードの結果
シスコが行った検証では Google の Gemini 3.1 Pro Preview 版が悪意ある画像攻撃に対し、画像モデルでは最高となる 93.9% というパフォーマンスを記録しました。次点は Anthropic の Claude Opus 4.5(93.7%)で、どちらもリーダーボードの「Excellent(優)」(85~100%)に分類されるスコアを記録しました。一方、最もパフォーマンスが低かったのは Mistral の Magistral Small 2509 で、拒否できたのはわずか 23.0% の攻撃にとどまりました。この結果は、検証に用いられた画像ベースの攻撃のうち、4 分の 3 以上の指示を実行したことを意味します。
画像を検証する上での違いは、画像ベースの攻撃では、密かに指示が埋め込まれた単一の画像を使用してシングルターンで実行する方法であり、会話のやり取りは行わない点です。攻撃手法に関する違いは形式だけでなく、種類にもあります。デザイン上のトリックを使用した画像埋め込みのテキストや図表に埋め込んだ指示、攻撃意図を画像と併用のテキストプロンプトに分割することでどちらも単体では有害に見えないように細工した攻撃などを用いています。リーダーボードには、実際に画像を見ることができるモデルの評価結果が表示されます。リーダーボードで扱っている 136 種類のモデルのうち、55 種類がこれに該当します。

図 2. Cisco LLM Security Leaderboard の音声対応モデルランキングのスクリーンショット
音声モデルのリーダーボードの結果
最新の検証では、音声モデルの中で最高のパフォーマンスを記録したのは Google の Gemini 3.1 Pro Preview 版でした。悪意ある音声攻撃の 90.0% を拒否したこのモデルとは対照的に、Mistral の Voxtral Small 24b(2507)は拒否率がわずか 9.0% となっており、およそ 10 回に 9 回は音声攻撃の指示に従ったことになります。
画像モデルのように音声モデルの検証もシングルターンのみで行い、会話ではなく悪意ある音声クリップ 1 つを使用しています。音声モデル部門は、このリーダーボードで最も新しく、対象モデル数も最も少ないカテゴリです。現状で音声入力を受け付けている Google、Mistral、OpenAI の 9 種類のモデルしか検証していないため、このランキングは未成熟分野における初期の結果としてみる必要があります。
合計スコアの結果ビューの見方
すでにリーダーボードに掲載されているモデルのテキストスコアは変化しませんが、モデルの検証に使われたテキスト、画像、音声モダリティの平均値の算出結果を示す合計スコアは変動します。合計スコアはたとえテキストのスコアが同じでも、画像の結果か音声の結果が違えば変化する可能性があります。
どちらに変化するかは、モデルの画像または音声耐性が、テキスト耐性と比較してどうであるかによって決まります。テキストの評価が高い一部のモデルでは、画像の評価を組み込んだ途端にスコアが下がったことを確認しています。Claude Sonnet 4.5 は 7.2 ポイントの低下(92.2 から 85.0)となり、合計スコアは 2 位から 20 位に落ちました。Claude Haiku 4.5 は 8.1 ポイントの低下で 4 位から 24 位に、Amazon Nova 2 Lite は 11.2 ポイントの低下で 25 位から 50 位に順位を落としました。どのモデルもテキスト耐性と比べて画像耐性が弱いという有意な差が認められたことが原因です。Mistral Voxtral の 2 種類のモデルでは、音声スコアが低かったという同じ理由で合計スコアが低下しました。
他のモデルでは、画像の評価がクロスモーダルスコアに追加された際にスコアが増加しています。画像耐性の検証を行った Google の 4 種類の Gemini モデルは、テキストに対する画像の優位性がどのモデルよりも優れているという結果でした。同様の検証を行った Gemma 3 の 3 つのバリエーションと OpenAI の GPT-4.1 nano、GPT-4.1 mini、GPT-4o mini も、テキスト耐性と比較して画像耐性に優れた適性を示しました。このような特性のばらつきは、あるモダリティではセキュリティが効果的だったからと言って、それが他のモダリティにもそのまま当てはまるわけではないことを示しています。画像や音声機能を最初のテキストモデルとは別に構築し、トレーニングしたラボに検証が及ぶ場合はなおさらです。
異なるモダリティを対象に検証を行ったモデルでは、合計スコアが大きく変動する場合があります。モデルのセキュリティ態勢のバランスがモダリティによって異なっている場合は、その変化が特に顕著になります。この変動はスコアの算出方法によるものであり、モデル自体の防御性能が実際に変化したことを意味するものではありません。各モデルのテキスト、画像、音声の列を別々に確認してから、合計スコアを全体像としてとらえるようにしてください。
AI Supply Chain Provenance Explorer との統合
来歴の考え方が重要なのは、あるモデルの弱点がそのモデルに固有の特性ではないことが多いためです。2 つのモデルが同じ系統に属している場合、あるモデルで発見された脆弱性は他方にも存在する可能性があります。調査対象を現在導入しているモデルだけに限定すると、問題が実際にどこで発生したのか、また同じ問題がほかのどこで表面化する可能性があるのかを見落とすおそれがあります。そうした事情から、モデルのセキュリティ調査に取り組み、何と関連があるのかを知る必要があるときには、来歴が非常に有用なものになります。
シスコはそのような考えのもとで、リーダーボードを AI Supply Chain Provenance Explorer と関連付けて扱っています。ランキングページのコアコンポーネントが一般公開されているモデル(オープンウェイトモデル)は、そのモデルの来歴プロファイルに直接リンクされており、Model Provenance Kit で使用されているのと同じ手法で抽出した系統とフィンガープリントのデータを確認できます。セキュリティ態勢とモデルの来歴は関連性のある問題であるため、同じ場所で簡単に閲覧できるように配慮しました。
Cisco LLM Security Leaderboard ではランキング全体の確認や、モダリティによるフィルタリング、特定モデルの検索などができます。ぜひご活用ください。
Authors
Log in to comment