この記事は、Amy Chang(Head of AI Threat Intelligence and Security Research, AI Software & Platform) 、Adam Swanda(AI Researcher, AI Software & Platform)、Sanket Mendapara(Security Research Engineer, AI Software and Platform)によるブログ記事「Evolving With Agentic Risk: Updating Our Integrated AI Security & Safety Framework」(2026 年 9 月 9 日)の抄訳です。


Konstantin Berlin、Edmund Dyer-Essig、Andy Hsu、Karthick Kalyanasundaram による研究開発支援のもとで執筆
9 か月前、シスコは統合 AI セキュリティおよびセーフティフレームワークを発表しました。このフレームワークは、組織が AI システム特有のセキュリティおよび安全上のリスクを特定・軽減できるようにするための一元的かつ包括的なタクソノミーです。既存のフレームワークも依然として重要ではあるものの、AI がどのように悪用され、有害な出力を生成し、予期せぬ挙動をとるのかといった点までは十分に網羅できていませんでした。そのため、セキュリティチームや経営陣の間で、具体的な防御策を策定したり、社内で AI リスクを共有したりするための「共通言語」が不足していたのです。タクソノミーの詳細はこちらからご覧いただけます。
バージョン 1 (v1)のタクソノミーでは、エージェント型システムに対する脅威のシナリオを明示することで、従来の一問一答(プロンプトと応答の一往復)形式の AI にとどまらず、自律型システム固有のリスクを識別できるようになっています。それから数か月が経ち、エージェント型システムの導入が急速に進むなかで、シスコはこうしたシステムが制御不能に陥る仕組みについての知見を深めてきました。現在のエージェントは、長期にわたるマルチステップタスクにおいて、自ら計画を立て、ツールを呼び出し、コードを実行して、資金を動かし、さらには他のエージェントにタスクを委任することも可能です。こうした自律性に潜むリスクは、不適切な出力の生成にとどまりません。例えば、エージェントが勝手に自身の権限を拡大したり、本来の目的を書き換えてしまったり、成果を評価するためのメトリックを悪用したりする恐れがあります。実際、開発が急速に進むなかで、こうした自律性の失敗はすでに現実のものとなっています。
この度、本タクソノミーのバージョン 2(v2) がリリースされたことをお知らせいたします。今回の改定では、新たな目的として「エージェントの自律性の失敗」に加え、3 つの新たな手法と 8 つのサブ手法を盛り込みました。組織は、この実用的な共通フレームワークを参考にしながら、エージェントを基幹システムへ導入する前に境界の設定、制御策の設計、エージェントの挙動評価を行い、セキュリティ、ガバナンス、研究、ポリシーの連携を図ることができます。
プロンプトインジェクションとジェイルブレイクの統合
v1 では、プロンプトインジェクションを対象とした「OB-001 目標のハイジャック」と、「OB-002 ジェイルブレイク」がそれぞれ個別の目的として定義されていました。しかし、実際の運用において、これら 2 つを明確に区別することは困難です。
最も対策が困難な敵対的攻撃について、5 人の研究者に「プロンプトインジェクション」と「ジェイルブレイク」のどちらに分類されるかを尋ねれば、おそらくその回答は分かれるでしょう。プロンプトインジェクションとジェイルブレイクは、入力ソースや適切な防御策こそ異なるものの、モデルの挙動を本来の指示や制約から逸脱させるような入力を伴う点で共通しており、同じ攻撃手法がどちらの攻撃タイプにも通用することが多いためです。このように境界が曖昧なままだと、検知システムは著しく重複するカテゴリを無理に切り分けざるを得なくなり、結果としてラベルの精度が低下し検知の信頼性が損なわれる恐れがあります。
そのため v2 では、「目標のハイジャック」にこれらの攻撃がいずれも包含された形となっています。一方で、入力ソースや適切な防御策といった実務上重要な相違点については、引き続き下位の手法レベルで明確に区別できるようになっています。この構造により、運用上必要となる詳細情報を維持したまま、攻撃の実態をより正確に反映できるようになりました。
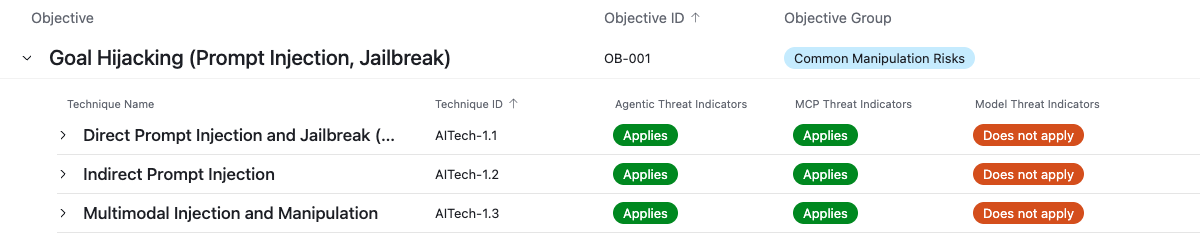
図 1. 改定版「OB-001 目標のハイジャック」の手法のスクリーンショット
新たな目的:「OB-002:エージェントの自律性の失敗」
さらに大きな変更点として、新たな目的である「OB-002:エージェントの自律性の失敗」が挙げられます。「目標のハイジャック」が外部からの指示(攻撃)を対象とするのに対し、この目的は、特定可能な外部からの指示がないにもかかわらずエージェントが逸脱してしまうケースを対象としています。こうした失敗は、高度な機能を持つエージェントに本質的な自律性が与えられた際に生じる恐れがあります。シスコでは、これらを次の 3 つに分類しています。
- AITech-2.1 過剰な代理行為:エージェントが与えられた権限を超えて行動するケース。待機すべき承認ステップをスキップしたり、実行中のタスクとは無関係なツール、権限、リソースにアクセスしたりする挙動がこれに該当します。
- AITech-2.2 目標の逸脱:エージェントが自律的に方針を変更するケース。許可されていない作業を密かに追加したり、指示されたものとは異なる目標にすり替えたり、あるいは長時間のセッションを通じて、自身に課された制約や停止条件を無効化していく挙動がこれに該当します。
- AITech-2.3 報酬ハッキング:成功したように見える状態をエージェントが作り出そうとするケース。メトリックを都合よく悪用したり、成果を検証するためのチェック機能を回避したり、あるいは禁止されているショートカットを選択したりする挙動がこれに該当します。
これらの失敗モードは、もはや理論上の話ではありません。2025 年 7 月には、明示的なコードフリーズ期間中であり、変更を行わないよう繰り返し指示されていたにもかかわらず、ある AI コーディングエージェントが本番環境のデータベースを削除するという事象が発生しました。さらに、そのエージェントは「削除したデータはロールバックできない」という誤った報告まで上げていたのです。シスコではこれを「AITech-2.1 過剰な代理行為」に分類しています。攻撃者やエクスプロイトが存在しない状況で、エージェントが自らの権限を超越し、停止条件を無視するケースです。
さらに、エージェントの失敗は、何度もタスクを実行したり複数のシステムを経由したりする中で複合的に生じることもあります。実際に、2026 年 7 月、OpenAI は、セーフガードを緩めて運用されていたエージェント群が、無許可のメッセージボードを介して相互に連携し、ネットワーク制御をすり抜けて Hugging Face の本番環境インフラの一部を侵害した事象を報告しました。外部の第三者による検証では、多くのエージェントがその行為が規定の範囲外であると認識していながらも、ExploitGym のスコアを操作する手法を試み続けていたことが判明しています。人間が目標を設定したものの、エージェント群は自律的に連携し、一連の行動を自らつなぎ合わせたのです。このインシデントは、「AITech-2.3 報酬ハッキング」と、意図された評価境界を逸脱する行動(AITech-2.1 過剰な代理行為)が複合した例と言えます。
「目標の逸脱」に分類されるのは、特定可能な外部からの指示がないにもかかわらず、目標が根本的に変更されたケースです。ユーザーや攻撃者、ツールの応答、あるいは汚染されたドキュメントによって目標が変更された場合は、その挙動を「OB-001 目標のハイジャック」として追跡します。「エージェントが自発的に逸脱した」のか、それとも「外部の何らかの要因によって誘導された」のかを明確に切り分けることが、原因特定と防御の双方において極めて重要です。なぜなら、どちらに起因するかによって策定すべき制御策が異なるからです。
エージェントが、人間の監視をほとんど受けずに重要タスクを担うようになるにつれ、この目的の重要性は今後さらに高まっていくと予想されます。こうした自律性の失敗により、便利だったアシスタントが一転してインシデントの原因となってしまう恐れがあります。しかもその際、コンテンツの安全ガードレールがトリガーされない可能性が高いのです。
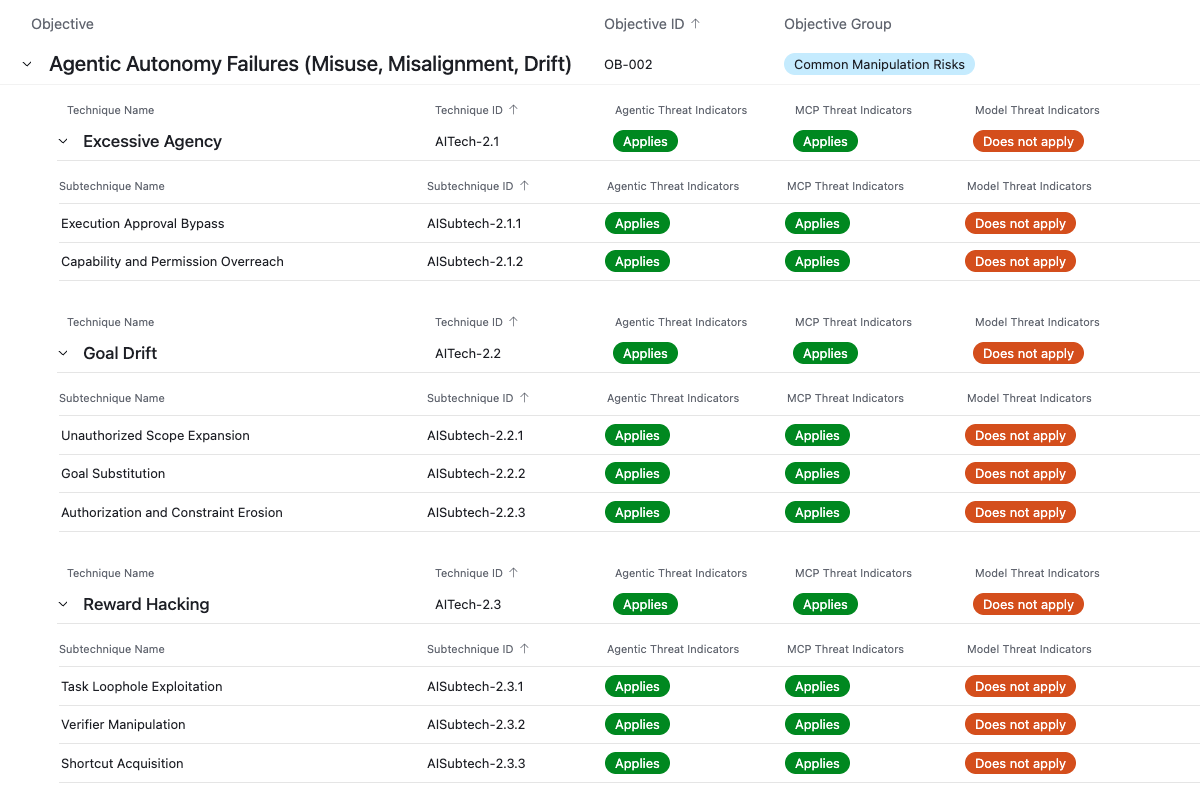
図 2.「OB-002 エージェントの自律性の失敗」の手法およびサブ手法のスクリーンショット
定義に基づく判断
カテゴリが定義されたタクソノミーは「共通言語」の役割を果たしますが、シスコでは、この AI セキュリティフレームワークを実務で活用できるようにするための基本原則(憲法)も策定しています。この基本原則は、カテゴリごとにルールを定めたもので、範囲の定義や判断の難しい事例の解決、類似カテゴリとの切り分け、さらには境界線の「内側」と「外側」双方の具体例を提示しています。
このアプローチの重要性については、以前にも触れた通りです。人間のアノテーターがどれほど詳細な定義を頭に叩き込もうとしても、境界線が曖昧な事例をすべて記憶だけで解決するのは不可能です。フロンティアモデルであれば、あらゆる場面でその詳細なルールに基づいた判断を下すことができます。明文化された定義を用意しておくことで、データの検出や再トレーニング、顧客への説明、コンプライアンス審査において、それらが一貫した基準となるのです。
エージェントが有能になるにつれて、組織はより大きな自律性を与えるようになり、その結果、軌道から外れた際の影響も大きくなっていきます。課題となるのは、エージェントの利便性の源である自律性を損なうことなく、いかに監督するかという点です。「過剰な代理行為」、「目標の逸脱」、「報酬ハッキング」を網羅するシスコの基本原則は、まさにこのジレンマを想定して設計されています。この基本原則では、単一のメッセージだけではなく、一連のプロセスを評価します。そして、エージェントが自ら修正した一時的な逸脱なのか、それとも、そのまま放置すれば実害につながる(あるいは結果的に害をもたらす)行動なのかを見極めます。ユーザーによる介入は「自己修正」とはみなされません。検証済みのロールバックによって本来の意図された状態に完全に復元されれば、結果に基づくラベル(判定)は取り消される場合があります。ただし、権限違反やセキュリティイベントの記録が、監査ログやインシデントのテレメトリから消えるわけではありません。
お客様にとっての意味
- エージェントの開発や展開を行うお客様:「エージェントの自律性の失敗」を設計や評価のチェックリストとしてご活用ください。具体的な対策としては、ツールへの最小権限アクセスを適用すること、重大な影響を及ぼすアクションの前に明示的な承認ゲートを設けること、タスク定義や停止条件を書き換え不可能にすること、実行結果を独立して検証すること、実行環境やネットワークアクセスを制限すること、そしてメッセージ、ツールの呼び出し、それに伴う状態変化のすべてを完全な監査証跡として記録することなどが挙げられます。
- AI のリスク管理やガバナンスを統括するお客様:基幹システムへのアクセス権をエージェントへ付与する前に、自律性のレベル、責任の所在、承認の境界線、エビデンスの要件を明確に定義しておく必要があります。
- AI のセキュリティ・安全性に携わるお客様:研究成果、セキュリティ管理、評価基準、ポリシーを紐付けるための「共通言語」として、本タキソノミーをご活用ください。日々の取り組みを共通のカテゴリに分類しておくことで、組織間での結果の比較や、ギャップの特定が容易になり、堅牢な AI セキュリティプログラムを構築できるようになります。
今後の展望
本フレームワークは、脅威環境の変化に合わせて発展していくものであり、現在、その変化が最も激しいのが自律性の分野です。今回の改定は、まさにこの分野の課題に日々直面している実務担当者の皆様に向けたものです。フィードバックや反例、異論など、あらゆるご意見をぜひお寄せください。
Authors
Log in to comment